Stabil heißt nicht automatisch upgradefähig
Für mich steckt genau hier die wichtigere Erkenntnis hinter dem konkreten AWS-Fall.
Im täglichen Betrieb prüfen wir vor allem, ob der aktuelle Zustand funktioniert.
Bei einem Major Upgrade müssen wir eine andere Frage stellen:
Ist der heutige Zustand auch mit den Regeln der zukünftigen Plattform kompatibel?
Damit verändert sich auch die technische Vorbereitung.
Natürlich bleiben CPU, Speicher, Backup-Status, Wartungsfenster und Storage-Kapazität relevant. Aber wir müssen auch verstehen, welche Rollen voneinander abhängen, welche Extensions installiert sind, welche Konfigurationen sich zwischen den Versionen verändern und auf welches Verhalten sich Anwendungen verlassen.
Wir müssen also unter die Oberfläche schauen.
Vieles davon weiß PostgreSQL bereits
Das ist die gute Nachricht: Viele dieser Informationen müssen wir nicht aus Dokumentationen oder alten Architekturdiagrammen rekonstruieren.
PostgreSQL kennt seine eigene Struktur. In Systemkatalogen führt die Datenbank Buch über all ihre Objekte und Beziehungen:
pg_rolesliefert uns die Liste aller existierenden Rollen (die Knoten in unserem Graphen).pg_auth_membersist das eigentliche Herzstück für unser Problem: Diese Systemtabelle speichert exakt die Beziehungen zwischen den Rollen – also welche Rolle Mitglied einer anderen Rolle ist (die Kanten unseres Graphen). Erst durch das Auslesen dieser Tabelle werden die Verbindungen überhaupt sichtbar.pg_extensionzeigt installierte Extensions.pg_settingsliefert die wirksame Konfiguration.pg_dependmacht Abhängigkeiten zwischen Datenbankobjekten nachvollziehbar.
Warum ist pg_auth_members für das konkrete Rollenproblem so entscheidend?
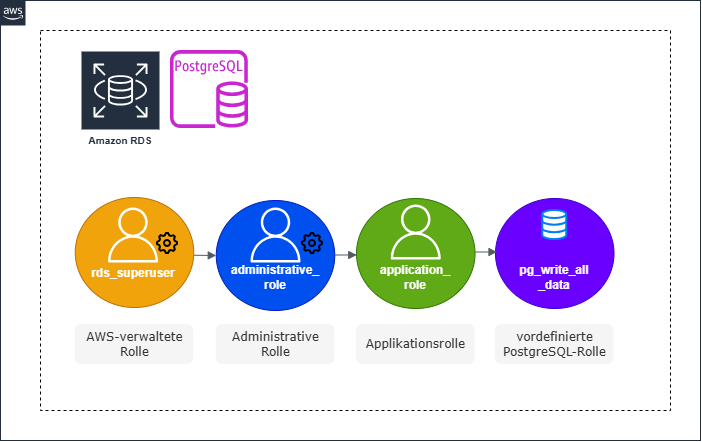
Da PostgreSQL Rollenmitgliedschaften flach Tabelle für Tabelle abspeichert (Rolle A enthält Rolle B), sieht man auf den ersten Blick nur direkte Zuordnungen. Um die viel gefährlicheren transitiven Berechtigungspfade über mehrere Ebenen aufzudecken, müssen wir diese Tabelle rekursiv abfragen.
Mit einer passenden Abfrage – PostgreSQL stellt dafür WITH RECURSIVE zur Verfügung – hangeln wir uns entlang der Eintragszeilen von pg_auth_members durch den gesamten Graphen. So lassen sich vollständige Pfade über beliebig viele Zwischenrollen hinweg auflösen.
Aus einer im Alltag unsichtbaren Beziehungskette wird dann transparent: rds_superuser → administrative_role → application_role → pg_write_all_data
Erst der Blick in pg_auth_members macht aus einzelnen Berechtigungen ein zusammenhängendes Bild. Damit wissen wir nicht nur, dass ein Risiko existiert, sondern sehen gemeinsam mit den Kolleginnen & Kollegen auch, wie es entstanden ist. Genau an dieser Stelle wird aus Troubleshooting Engineering.
Vom einzelnen Check zum technischen Preflight
Für den konkreten AWS-Fall könnten wir eine passende Abfrage ausführen, das Ergebnis prüfen und anschließend das Upgrade starten. Bei einer einzelnen Datenbank mag das genügen. Wenn wir aber mehrere Datenbanken betreiben, regelmäßig Major Upgrades durchführen oder eine größere Cloud-Plattform verantworten, wollen wir daraus einen wiederholbaren Prozess machen.
Wir können relevante Metadaten automatisiert auslesen und gegen bekannte Anforderungen der Zielversion prüfen: Rollenpfade, Extensions, Konfigurationsparameter oder versionsabhängige Datenbankobjekte.
Solche Checks lassen sich in eine bestehende CI/CD-Pipeline integrieren oder beispielsweise über AWS CodeBuild ausführen.
Das konkrete Werkzeug ist für mich dabei zweitrangig.
Wichtiger ist, dass der Check reproduzierbar läuft, seine Ergebnisse nachvollziehbar dokumentiert und kritische Findings sichtbar macht, bevor das eigentliche Upgrade beginnt. Das ist unser technischer Preflight.
Und trotzdem würden wir nicht zuerst in Produktion upgraden
Ein solcher Preflight kann bekannte Konflikte sehr gut erkennen. Er kann aber nicht garantieren, dass wir jede Besonderheit einer gewachsenen Datenbank vorab modelliert haben.
Deshalb gehört für uns zu einem belastbaren Major Upgrade auch ein realistischer Test der Zielversion.
In AWS bietet sich dafür ein naheliegender Weg an: Aus einem aktuellen Snapshot stellen wir eine isolierte RDS-Instanz beziehungsweise einen separaten Aurora-Cluster her und führen das Major Upgrade dort durch.
Damit testen wir nicht gegen eine künstliche Beispieldatenbank, sondern gegen Strukturen, die der produktiven Umgebung tatsächlich entsprechen: Rollen, Extensions, Datenbankobjekte, Konfigurationen und reale Datenmengen.
Und danach reicht uns ein grüner Upgrade-Status nicht.
Wir wollen wissen, ob Rollen und Berechtigungen weiterhin funktionieren. Ob die benötigten Extensions verfügbar sind. Ob Anwendungen sich authentifizieren können. Ob repräsentative Queries das erwartete Ergebnis liefern. Und auch, wie lange der gesamte Vorgang unter realistischen Bedingungen tatsächlich benötigt.
Damit verändert sich die Rolle des produktiven Wartungsfensters entscheidend:
Es ist nicht mehr der erste echte Upgrade-Versuch, sondern die kontrollierte Wiederholung eines bereits erprobten Ablaufs.
Automatisierung findet das Problem. Engineering löst es.
Nehmen wir an, unser Preflight findet tatsächlich einen Rollenpfad, der beim Upgrade einen Zyklus erzeugen würde.
Technisch erscheint die Lösung zunächst einfach: Wir entfernen die Mitgliedschaft, die später den Kreis schließen würde.
Problem gelöst?
Nicht unbedingt.
Vielleicht benötigt eine Anwendung genau die Berechtigung, die wir gerade entfernt haben.
Deshalb würden wir nicht bei der Diagnose stehen bleiben. Wir wollen verstehen, warum diese Mitgliedschaft existiert, welche Benutzer oder Anwendungen davon abhängen und ob sich die benötigten Rechte gezielter vergeben lassen.
Vielleicht braucht eine Anwendung gar kein pg_write_all_data, sondern lediglich Schreibzugriff auf einige definierte Tabellen und die dazugehörigen Sequenzen.
Dann wird aus einem Upgrade-Problem plötzlich eine Architekturfrage.
Und das bekannte Prinzip der minimal notwendigen Berechtigungen bekommt noch eine weitere Dimension: Ein präziseres Rollenmodell erhöht nicht nur die Sicherheit. Es reduziert auch implizite Abhängigkeiten – und damit mögliche Überraschungen bei späteren Upgrades und Migrationen.
Genau das kann kein automatisierter Check allein entscheiden.
Automatisierung kann uns zeigen, wo wir hinschauen müssen. Engineering bedeutet zu verstehen, was wir dort verändern dürfen.
Der Rollenzyklus ist nur ein Beispiel
Der AWS-Fall ist besonders anschaulich. Das Prinzip dahinter reicht aber deutlich weiter.
Eine PostgreSQL-Datenbank besteht aus vielen solchen Beziehungen.
Views hängen von Tabellen oder anderen Views ab. Funktionen verwenden Datentypen, Extensions oder weitere Funktionen. Trigger verweisen auf Funktionen. Anwendungen verlassen sich auf Treiber, Authentifizierungsverfahren und bestimmtes SQL-Verhalten. Auch Konfigurationen verändern sich zwischen Major-Versionen.
Deshalb verstehen wir einen technischen Preflight nicht als einmalige Checkliste für ein einzelnes Rollenproblem.
Wir können ihn mit der Plattform weiterentwickeln.
Heute prüfen wir einen bekannten Rollenzyklus. Beim nächsten Upgrade ergänzen wir einen Check für eine kritische Extension. Später vielleicht eine Prüfung für einen veränderten Parameter.
So entsteht aus einzelnen technischen Erkenntnissen Schritt für Schritt ein Sicherheitsnetz für zukünftige Veränderungen.
Eine Ebene tiefer in der Datenbankmodernisierung
In unserem ersten Beitrag dieser Reihe haben wir beschrieben, warum der Weg vom Datenbank-Monolithen in die Cloud zunächst eine Architekturentscheidung ist.
Im zweiten Teil ging es darum, wie sich gewachsene Oracle-Datenbanken kontrolliert in moderne Cloud-Architekturen überführen lassen.
Mit dem PostgreSQL-Beispiel gehen wir jetzt bewusst eine Ebene tiefer. Denn selbst wenn Zielarchitektur und Migrationsweg sauber definiert sind, bleiben die technischen Details einer gewachsenen Plattform: Rollen. Extensions. Konfigurationen. Objektabhängigkeiten. Anwendungsschnittstellen.
Genau dort entscheidet sich häufig, ob eine auf dem Papier saubere Modernisierung auch in der Realität funktioniert. Für uns bei PROTOS bedeutet Datenbankmodernisierung deshalb nicht nur, eine Engine auszutauschen oder einen Workload in AWS zu verschieben. Wir wollen verstehen, was technisch unter der Oberfläche passiert. Dafür analysieren wir Abhängigkeiten, machen Risiken frühzeitig sichtbar und testen Veränderungen gegen realistische Systeme, bevor sie den produktiven Betrieb erreichen.
Denn eine Datenbank, die heute stabil läuft, ist noch lange keine Datenbank, die sich morgen problemlos weiterentwickeln lässt.
Fazit: Das Wartungsfenster sollte nicht der Moment der Wahrheit sein
Ein Major Upgrade ist mehr als ein Versionswechsel.
Der von AWS beschriebene Fall zeigt das an einem erstaunlich kleinen technischen Detail: Eine über Jahre funktionierende Rollenstruktur kann durch eine Änderung der Zielversion plötzlich einen zirkulären Pfad erzeugen – und damit das gesamte Upgrade verhindern.
Das klingt zunächst nach einem Spezialfall.
Für mich zeigt es aber etwas Grundsätzlicheres: Viele Upgrade-Risiken sind bereits vor dem Upgrade im System vorhanden. Wir müssen nur wissen, wonach wir suchen.
PostgreSQL liefert uns dafür die Metadaten. Wir können sie analysieren, daraus automatisierte Preflight-Checks entwickeln und die Zielversion anschließend gegen eine realistische Kopie der produktiven Umgebung testen.
So verschiebt sich der entscheidende Moment nach vorne. Wir entdecken das Problem nicht während des Wartungsfensters, sondern wir entdecken es vorher.
Und genau dort beginnt für uns kontrolliertes Cloud Engineering.